יש לכם תיקייה עם מדריכים, סיכומי פרויקטים והערות שכתבתם במהלך העבודה. אתם שואלים מודל שפה איך הגדרתם את הגיבוי בפרויקט האחרון. בלי לקבל את המסמכים, אין לו דרך לדעת מה עשיתם שם. הוא עשוי להציע דרך סבירה להגדיר גיבוי, אבל זו שאלה אחרת.
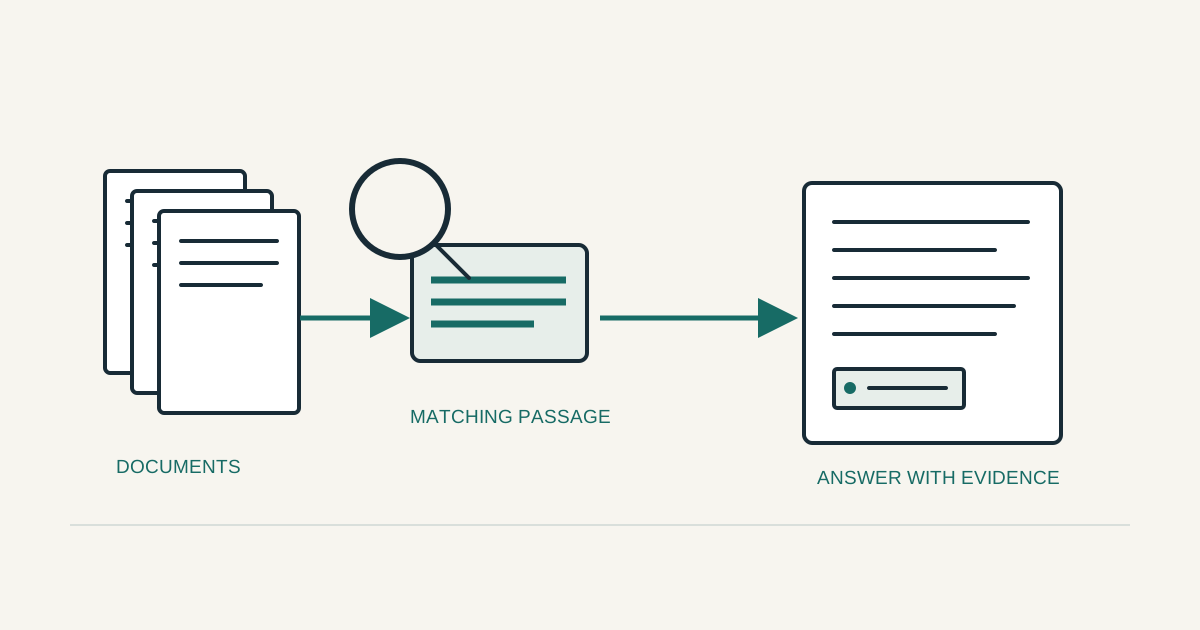
RAG, ראשי תיבות של Retrieval-Augmented Generation, מחבר בין חיפוש מידע לבין יצירת תשובה. המערכת מחפשת חומר רלוונטי, מעבירה אותו למודל יחד עם השאלה ומבקשת תשובה שמסתמכת עליו. זהו הדפוס הבסיסי שמתואר בתיעוד Azure AI Search.
מה משתנה כשמוסיפים חיפוש?
במקום לשלוח רק שאלה, שולחים גם הקשר שנמצא במסמכים. המודל יכול לראות את הפסקה שמסבירה את הגיבוי בפרויקט המסוים, ולא רק להסתמך על מידע כללי שנלמד באימון.
לדוגמה, נניח שבמסמך כתוב:
הגיבוי של תיקיית הפרויקט מתבצע בכל ערב. עותק השחזור נשמר בכונן נפרד, ובדיקת שחזור מתבצעת בתחילת כל חודש.
זהו קטע מומצא לצורך ההסבר. מתוך הקטע הזה אפשר לענות על תדירות הגיבוי ועל בדיקת השחזור. אי אפשר להסיק ממנו באיזו תוכנה משתמשים או אם הכונן נמצא מחוץ לבית. תשובה טובה צריכה להבחין בין מה שכתוב לבין מה שחסר.
RAG רגיל מספק חומר בזמן הבקשה. הוא אינו מחייב אימון מחדש של המודל על המסמכים. ההבחנה הזו מופיעה גם בהסבר של Microsoft על RAG ואינדקסים.
החיפוש הוא חלק מהתשובה
אם מנוע החיפוש מוצא מסמך לא מתאים, המודל מקבל חומר לא מתאים. גם ניסוח מצוין לא יתקן את זה בהכרח. לכן כדאי לבדוק את תוצאות החיפוש בפני עצמן, לפני שמוסיפים שלב של כתיבה.
אפשר לעשות ניסוי קטן: להכין עשר שאלות ולסמן מראש איזה מסמך אמור לענות על כל אחת. אחר כך מריצים רק את החיפוש ובודקים אם המקור הנכון מופיע בתוצאות הראשונות. הבדיקה הזו מפרידה בעיית חיפוש מבעיה בניסוח התשובה.
שאלה שאין לה תשובה באוסף חשובה לא פחות. אם שואלים על תוכנת הגיבוי והמסמכים אינם מציינים אותה, מערכת שימושית צריכה לזהות שחסר מידע. החזרת קטע שעוסק בגיבוי אינה מספיקה כדי להוכיח שהוא עונה על השאלה.
דוגמה מקומית לשלב החיפוש
הדוגמה הבאה מחפשת התאמות למילים בתוך שלושה קטעים. היא מדגימה את שלב השליפה בלבד: אין כאן מודל שפה, embeddings (וקטורים שמייצגים את משמעות הטקסט) או חיפוש סמנטי. אפשר להריץ אותה ב־Node.js 22 ומעלה בלי התקנת חבילות.
שמרו קובץ בשם retrieve.mjs:
const chunks = [
  {
    id: "backup-schedule",
    source: "backup-guide.md",
    text: "הגיבוי מתבצע בכל ערב. בדיקת שחזור מתבצעת בכל חודש."
  },
  {
    id: "network-map",
    source: "network-guide.md",
    text: "רשימת המכשירים ברשת כוללת כתובת, חדר ושם מכשיר."
  },
  {
    id: "editorial-review",
    source: "publishing-guide.md",
    text: "כל מאמר עובר בדיקת מקורות לפני הפרסום."
  }
];

function retrieve(question) {
  const terms = [...new Set(
    question.toLocaleLowerCase("he")
      .split(/[^\p{L}\p{N}]+/u)
      .filter(Boolean)
  )];

  return chunks
    .map(chunk => ({
      ...chunk,
      score: terms.filter(term =>
        chunk.text.toLocaleLowerCase("he").includes(term)
      ).length
    }))
    .filter(chunk => chunk.score > 0)
    .sort((a, b) => b.score - a.score)
    .slice(0, 2);
}

console.log(retrieve("מתי מתבצע הגיבוי ובדיקת שחזור?"));
הריצו:
node retrieve.mjs
הקטע backup-schedule מופיע בתוצאה עם שם קובץ המקור. זהו פרט שכדאי לשמור לאורך התהליך: כשמייצרים תשובה, אפשר לקשר למקום שממנו הגיע המידע.
החיפוש הזה מוגבל. הוא בודק תתי־מחרוזות, אינו מבין מילים נרדפות ויכול להתאים מילה קצרה בתוך מילה אחרת. השאלה ״מתי שומרים עותק נוסף?״ עלולה לא למצוא דבר אף שהיא קשורה לגיבוי. הדוגמה עוזרת להבין את המסלול, ולא מחליפה מנוע חיפוש שמתאים לאוסף אמיתי.
למה מחלקים מסמכים לקטעים?
במדריך ארוך יכולים להיות סעיפים על התקנה, הגדרות ותקלות. אם השאלה עוסקת בתקלה אחת, עדיף שהחיפוש יוכל למצוא את הסעיף המתאים. החומר שמועבר למודל יהיה ממוקד יותר ויכלול פחות טקסט שלא עוזר לענות.
אבל חלוקה אגרסיבית מדי פוגעת במשמעות. המשפט ״אין להפעיל את האפשרות הזו״ אינו מועיל אם שם האפשרות נשאר בקטע הקודם. כותרת הסעיף, שם המוצר וגרסת ההוראות יכולים להיות חלק חשוב מההקשר.
אין מספר מילים אחד שמתאים לכל מסמך. מדריך עם פקודות, טבלה והסברים דורש חלוקה אחרת מסיכום פגישה. מדריך התכנון של Microsoft מתייחס להכנת הנתונים, לשליפה ולהערכת הפתרון כשלבים שיש לתכנן ולבדוק.
קישור למקור אינו בדיקת אמת
תשובה יכולה לכלול קישור נכון ועדיין לייחס למקור משהו שלא נאמר בו. בבדיקה ידנית צריך לפתוח את הקטע ולשאול אם הוא תומך בטענה המסוימת, לא רק אם הוא עוסק באותו נושא.
לדוגמה, מקור שמסביר איך להפעיל גיבוי אינו תומך אוטומטית בטענה שהגיבוי נבדק בהצלחה. מקור שפורסם לפני שינוי מוצר עלול לתאר התנהגות שאינה רלוונטית לגרסה הנוכחית. רצוי לשמור גם תאריך עדכון ומזהה סעיף כשאלה זמינים.
במערכת עם מסמכים פרטיים, החיפוש צריך להתחשב בהרשאות. משתמש לא אמור לקבל קטעים שאין לו הרשאה לקרוא, גם אם הם רלוונטיים מאוד לשאלה. באתר כמו HomeRan אפשר להתחיל מאוסף קטן של חומר ציבורי ומזוהה, ולדחות את מורכבות ההרשאות עד שנדרשת גישה לתוכן פרטי.
בדיקה לפני שמגדילים את האוסף
הכינו רשימת שאלות עם שלושה סוגי מקרים: תשובה שנמצאת בפסקה אחת, תשובה שדורשת שני מקורות ושאלה שאין לה תשובה בחומר. לכל שאלה שמרו את הקטעים שנשלפו ואת התשובה שנכתבה.
אם המקור הנכון לא הגיע למודל, שפרו את החיפוש או את חלוקת המסמכים. אם המקור הגיע אבל התשובה הוסיפה פרטים, בדקו את הוראות הכתיבה ואת דרך הביקורת. ההפרדה הזו נותנת כיוון לתיקון במקום להחליף רכיבים בלי לדעת מה נכשל.