Mistral AI הכריזה על Mistral Large 4, ובקצרה: זה המודל הגדול ביותר שהחברה שחררה עד היום, והוא יגיע עם משקלים פתוחים. כלומר, אפשר יהיה להריץ אותו על השרתים שלכם, בענן פרטי או בדאטה סנטר באירופה, בלי לעבור דרך ספק חיצוני. בכתבה הזו ריכזתי מה המודל יודע, מה המספרים שהחברה מפרסמת באמת אומרים, וממה כדאי להיזהר לפני שמחליפים מודל בפרודקשן.
הכתבה מבוססת על הכרזת Mistral Large 4 מ־6 באוקטובר 2026. כל המספרים כאן הם של Mistral עצמה, ולא בדקתי אותם באופן עצמאי.
מה זה Mistral Large 4
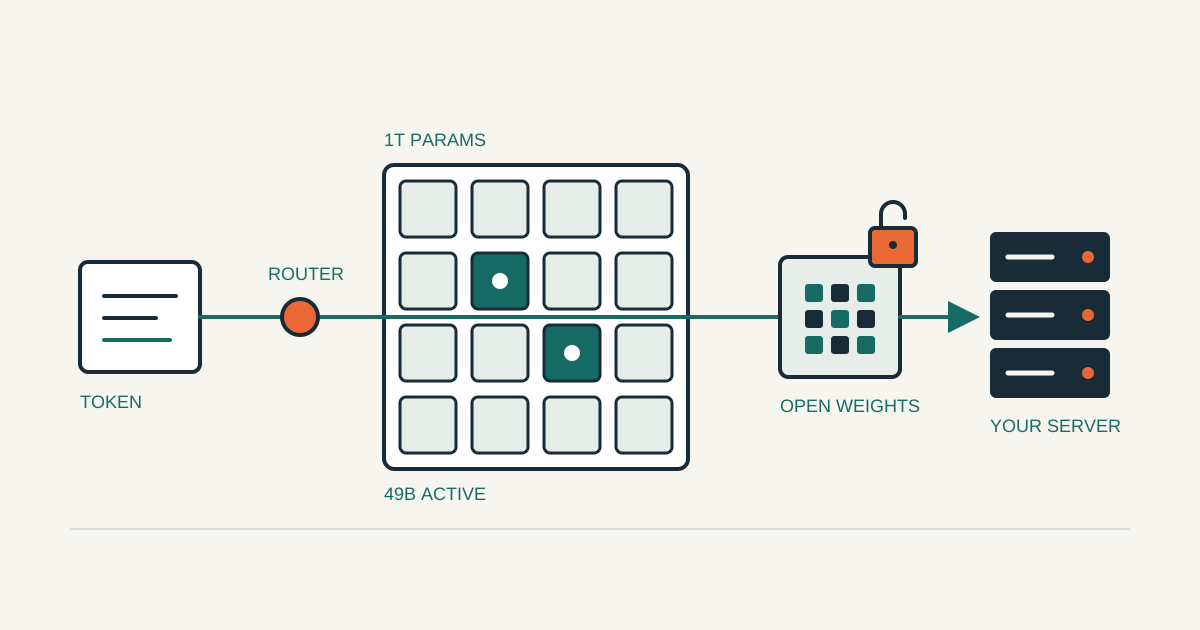
Mistral Large 4 (בקיצור ML4) הוא מודל מסוג Mixture of Experts, או MoE: מודל שמורכב מהרבה ״מומחים״ קטנים, ובכל צעד מופעלים רק חלק מהם. לכן יש שני מספרים:
- טריליון פרמטרים בסך הכול. זה הגודל של המודל כולו, וזה מה שקובע כמה זיכרון צריך כדי להחזיק אותו.
- 49 מיליארד פרמטרים פעילים. זה מה שרץ בפועל על כל טוקן, וזה מה שקובע את המהירות והעלות של כל תשובה.
ההבדל הזה הוא הסיבה שמודל ענק יכול להיות זול יחסית להרצה. עוד כמה עובדות בסיס:
- מודל היברידי: אותו מודל עונה גם תשובות ישירות (instruct) וגם עובד במצב חשיבה (reasoning) למשימות מורכבות.
- מולטימודלי מהיסוד: הוא מקבל גם תמונות, לא רק טקסט.
- רב־לשוני: אומן על יותר מ־160 שפות, כולל כל השפות הרשמיות של האיחוד האירופי.
- אומן באירופה: על 3,800 מעבדי NVIDIA Grace Blackwell בדאטה סנטרים של Mistral.
משקלים פתוחים: למה זה חשוב
רוב המודלים החזקים זמינים רק דרך API. אתם שולחים את המידע לספק, והוא מחזיר תשובה. עם משקלים פתוחים (open weights) אתם מקבלים את המודל עצמו, ויכולים להריץ אותו איפה שתרצו.
לפי ההכרזה, המשקלים ישוחררו עד סוף אוקטובר 2026, ברישיון שמאפשר הפצה ושימוש בלי מגבלות. זה פותח שלוש אפשרויות שלא קיימות במודל סגור:
- פריסה מקומית (on-premise) לארגונים שהמידע שלהם לא יכול לצאת מהרשת.
- ענן פרטי עם שליטה מלאה על הגרסה: המודל לא משתנה לכם מתחת לרגליים.
- פריסה אירופית מקצה לקצה, שלא תלויה בספקים אחרים. לחברות שכפופות ל־GDPR זה שיקול אמיתי.
משקלים פתוחים לא אומרים שזה ירוץ על המחשב הנייד. מודל של טריליון פרמטרים צריך כמה מעבדים גרפיים חזקים רק כדי להיטען לזיכרון. לרוב המפתחים, ה־API יהיה הדרך המעשית להתחיל.
המספרים: קוד, סוכנים ואבטחת מידע
Mistral פרסמה הרבה תוצאות. אלה שנראות לי הכי רלוונטיות למפתחים:
| תחום | מבחן | תוצאה |
|---|---|---|
| קוד | DeepSWE v1.1 | 61.7% |
| קוד | SWE-Atlas-QnA | 59.4% |
| קוד | Terminal Bench 4.0 | 28.3% |
| קוד | Coding Agent Index | 49.8% |
| סוכנים | AutomationBench (657 תהליכים עסקיים) | 59.9% |
| סוכנים | AA-Briefcase (עבודת ידע ארוכה) | 1,393 Elo |
| אבטחת מידע | Cybench (40 אתגרי CTF) | 93% |
| אבטחת מידע | שחזור חולשות | 82% |
| תמונות | Dense 200 (visual grounding) | 42% |
כמה דברים בולטים:
- אבטחת מידע היא התחום החזק. לפי Mistral, המודל נמצא בחמישייה הראשונה בעולם במדד Artificial Analysis Cyber Index, ומוביל בין המודלים הפתוחים מחוץ לסין. בשחזור חולשות, עם 82%, הוא קיבל את התוצאה הגבוהה ביותר מבין כל המודלים שנבדקו.
- בקוד הוא מתחרה, לא מוביל. ב־Coding Agent Index הוא לפני DeepSeek V4 Pro ו־Qwen3.8 Max. בהערכה אנושית של Surge AI הוא דורג שני מתוך חמישה מודלים, עם 3.74 מתוך 5.
- בתמונות הוא עוקף מודל סגור אחד: 42% ב־Dense 200, מול 41% של GPT-6-Astra.
מבחנים הם נקודת התחלה, לא תשובה. הם מראים איפה המודל חזק יחסית, אבל לא איך הוא יתנהג על הקוד, על השפה ועל המשימות שלכם.
בטיחות: חסין יותר, אבל מסנן פחות בתצוגה המקדימה
מודל שטוב באבטחת מידע הוא גם מודל שאפשר לנצל לרעה. Mistral מדווחת על עמידות של 93.3% בפני התקפות במבחן B3 AI Security Benchmark, ועל ציון 1.691 מתוך 2.0 במבחן KORA. היא גם כותבת ששיעור הסירוב של ML4 לבקשות סייבר מסוכנות גבוה מזה של כל המודלים הפתוחים שנבדקו.
פרט אחד חשוב: בתקופת התצוגה המקדימה, Mistral מפעילה סינון מופחת עבור צוותי red teaming (צוותים שתוקפים מערכת כדי למצוא בה חולשות), יחד עם חברות אבטחה ורשויות. אם אתם בונים מוצר לקהל רחב, אל תסמכו רק על הסינון של המודל. שכבת בדיקה משלכם נשארת חובה.
מחיר וזמינות
המודל זמין כבר עכשיו כתצוגה מקדימה ב־Mistral Studio, דרך console.mistral.ai:
- קלט: 1.36 דולר למיליון טוקנים.
- פלט: 4.18 דולר למיליון טוקנים.
- כלים: חיפוש ברשת, הרצת קוד ב־sandbox וקריאה ל־API חיצוני.
- אזורים: כמה אזורים בעולם, כולל פריסה אירופית מלאה.
למודל בגודל הזה זה מחיר נמוך. אם אתם מריצים סוכן שקורא הרבה קוד ומחזיר מעט טקסט, מחיר הקלט הוא מה שיקבע את החשבון.
איך אומן: למידת חיזוק בהיקף גדול
החלק הטכני המעניין בהכרזה הוא האימון שאחרי האימון הבסיסי (post-training). Mistral משלבת כוונון מפוקח (SFT, אימון על דוגמאות של תשובות נכונות) עם למידת חיזוק (RL, אימון שבו המודל מקבל ציון על התוצאה ולומד ממנו).
לפי Mistral, ריצת אימון אחת מייצרת כ־33 מיליארד טוקנים ביום, מהם כ־16 מיליארד נכנסים לאימון אחרי סינון. הציון מגיע מכמה מקורות יחד: מודלים מתגמלים, בדיקות יחידה, מודל שמשמש כשופט ובדיקות סטטיות. בשביל מי שבונה סוכנים, זה אומר שהמודל אומן במיוחד על משימות ארוכות ורב־שלביות, ולא רק על שאלה ותשובה.
מתי לשקול את Mistral Large 4
כדאי לבדוק אותו אם:
- המידע שלכם לא יכול לצאת מהארגון, ואתם צריכים מודל חזק שרץ אצלכם.
- אתם עובדים באירופה וצריכים פריסה שלא תלויה בספקים אמריקאים.
- אתם בונים כלים לאבטחת מידע או סוכנים לתהליכים עסקיים.
- המחיר לטוקן הוא חלק משמעותי מהעלות של המוצר.

כדאי לחכות אם:
- אתם צריכים מוצר יציב ובשל, ולא תצוגה מקדימה.
- המשימה העיקרית היא כתיבת קוד, ויש לכם כבר מודל שמוביל שם.
הדרך הנכונה להחליט היא לא טבלת מבחנים. קחו 20-30 משימות אמיתיות מהמוצר שלכם, הריצו אותן על המודל הנוכחי ועל ML4, והשוו תוצאות, זמנים ועלות.
בקצרה
- 01MoE ענק
טריליון פרמטרים בסך הכול, 49 מיליארד פעילים בכל טוקן.
- 02משקלים פתוחים
שחרור עד סוף אוקטובר, ופריסה מקומית או אירופית מלאה.
- 03חזק באבטחת מידע
במקומות הראשונים בסייבר ובסוכנים, מתחרה בקוד.
- 04זול ב־API
1.36 דולר לקלט ו־4.18 דולר לפלט, למיליון טוקנים.
הנתונים בכתבה לקוחים מהכרזת Mistral Large 4 בבלוג של Mistral AI. הסידור, ההסברים וההמלצות הם שלי.