הרבה מהשימושים במודל שפה במוצר אמיתי הם בכלל לא כתיבה. רוצים לדעת לאיזו מחלקה לנתב פנייה, אם בתמונה יש מוצר פגום, או כמה חמורה תקלה שמשתמש דיווח. עד היום עשינו את זה עם מודל שמחזיר טקסט, ואז פירקנו את הטקסט וקיווינו שהוא בפורמט הנכון. ה־Decisions API של OpenAI בנוי בדיוק למקרה הזה: הוא לא כותב, הוא מחליט, ומחזיר תשובה מוקלדת עם מספרים.
הכתבה מבוססת על המדריך הרשמי של Decisions API. ה־API נמצא בבטא ציבורית, ופרטים כמו המודל והמחיר עוד עשויים להשתנות.
מה Decisions API עושה
Decisions API מקבל טקסט, תמונות או את שניהם, ומחזיר תשובות מוקלדות (typed): הסתברות, בחירה מתוך רשימה או ציון על סולם. לפי OpenAI, הוא עושה את זה בערך פי 10 מהר יותר מ־Responses API.
ההבדל מהותי. במקום לבקש מהמודל ״תחזיר JSON עם שם המחלקה״ ולבדוק שהוא באמת עשה את זה, אתם מקבלים תשובה שכבר במבנה הנכון, יחד עם מידת הביטחון של המודל בה. אין טקסט לפרק, ואין תשובה ״כמעט נכונה״.
שלושה חלקים בכל בקשה
כל בקשה ל־POST /v1/decisions בנויה משלושה חלקים:
model: כרגע יש מודל אחד,gpt-6-luna.input: הראיות שהמודל בודק. מחרוזת טקסט, או הודעות משתמש עם טקסט ותמונות.questions: מערך של שאלות. לכל שאלה ישtype,nameייחודי,instructionsושדות שתלויים בסוג השאלה.
התשובה היא מערך answers, תשובה אחת לכל שאלה, עם אותו name.
שלושה סוגי שאלות
| סוג | מתי משתמשים | מה חוזר |
|---|---|---|
predicate | האם תנאי מתקיים? | probability בין 0 ל־1 |
choice | בחירה אחת מרשימה קבועה | choice, probabilities לכל אפשרות ו־confidence |
score | דירוג על סולם מסודר | score, probabilities לכל רמה ו־confidence |
לכל סוג יש מקום משלו. predicate לשאלות של כן או לא, כמו ״האם יש נזק גלוי במוצר״. choice לניתוב, כמו ״לאיזו מחלקה הפנייה שייכת״. score לחומרה או לאיכות, כשיש סדר בין הרמות.
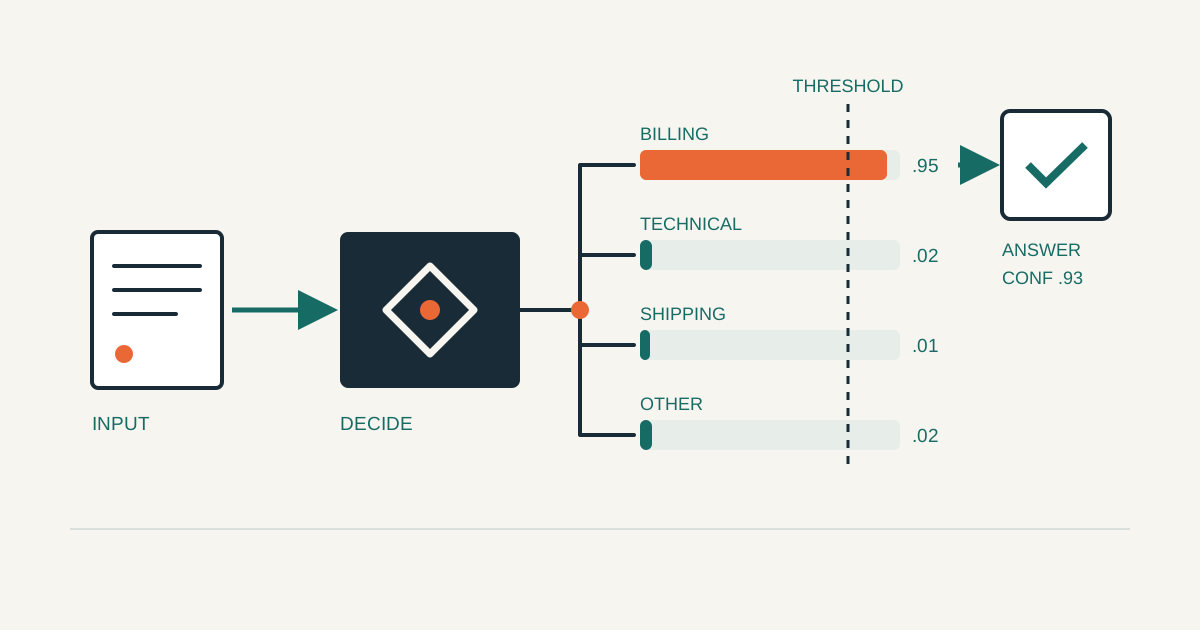
דוגמה: ניתוב פניות לשירות לקוחות
זו הדוגמה מהמדריך, ב־JavaScript. צריך את ה־SDK של OpenAI בגרסה 7.30.0 ומעלה:
import OpenAI from 'openai'

const client = new OpenAI()
const decision = await client.decisions.create({
  model: 'gpt-6-luna',
  input: 'I was charged twice for my order.',
  questions: [
    {
      type: 'choice',
      name: 'department',
      instructions: 'Which department should handle this complaint?',
      choices: [
        { value: 'billing', description: 'Payments, invoices, and refunds.' },
        { value: 'technical', description: 'Problems using the product.' },
        { value: 'shipping', description: 'Delivery and tracking.' },
        { value: 'other', description: 'Requests outside these categories.' },
      ],
    },
  ],
})

const answer = decision.answers[0]
if (answer.type === 'refusal') {
  console.log(`Refused: ${answer.name}`)
} else if (answer.type === 'choice') {
  console.log(`Department: ${answer.choice} (confidence: ${answer.confidence})`)
}
והתשובה:
{
  "answers": [
    {
      "type": "choice",
      "name": "department",
      "choice": "billing",
      "probabilities": [
        { "value": "billing", "probability": 0.95 },
        { "value": "technical", "probability": 0.02 },
        { "value": "shipping", "probability": 0.01 },
        { "value": "other", "probability": 0.02 }
      ],
      "confidence": 0.93
    }
  ]
}
שימו לב לשני דברים בקוד:
- בודקים קודם
refusal. המודל יכול לסרב לענות על שאלה, ואז התשובה היא מסוגrefusalולא מהסוג ששאלתם. קוד שקורא ישר אתanswer.choiceיקבלundefined. - האפשרות
otherהיא חלק מהעיצוב. בלעדיה, פנייה שלא שייכת לאף מחלקה תיפול למחלקה הלא נכונה, ועוד עם ביטחון גבוה.
דוגמה: זיהוי נזק בתמונה
בשאלת predicate המודל מחזיר הסתברות אחת. כאן הדוגמה ב־Python (SDK בגרסה 3.26.0 ומעלה):
import base64
from pathlib import Path

from openai import OpenAI

client = OpenAI()
image_base64 = base64.b64encode(Path("product.png").read_bytes()).decode("ascii")

decision = client.decisions.create(
    model="gpt-6-luna",
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "Inspect the product in this photo."},
                {
                    "type": "input_image",
                    "image_url": f"data:image/png;base64,{image_base64}",
                },
            ],
        }
    ],
    questions=[
        {
            "type": "predicate",
            "name": "visible_damage",
            "instructions": (
                "Does the product have visible damage, such as a crack, tear, or dent? "
                "Ignore shadows and damage to the packaging."
            ),
        }
    ],
)

answer = decision.answers[0]
if answer.type == "refusal":
    print(f"Refused: {answer.name}")
elif answer.type == "predicate":
    print(f"Visible damage probability: {answer.probability}")
התשובה תהיה למשל "probability": 0.92. שימו לב גם להוראה ״התעלם מצללים ומנזק לאריזה״: הוראה שאומרת מה לא נחשב היא מה שמונע הרבה התראות שווא.
את התמונה שולחים כ־data URL בתוך הבקשה. כתובת HTTP של תמונה או מזהה של קובץ שהועלה ל־OpenAI לא נתמכים כרגע.
דוגמה: דירוג חומרה של תקלה
בשאלת score מגדירים רמות לפי הסדר, והמודל מחזיר ממוצע משוקלל של מספרי הרמות:
const decision = await client.decisions.create({
  model: 'gpt-6-luna',
  input: 'Export fails in Safari but works in Chrome.',
  questions: [
    {
      type: 'score',
      name: 'severity',
      instructions: 'How severe is this issue?',
      levels: [
        { label: 'Cosmetic', description: 'Appearance only; no lost functionality.' },
        { label: 'Workaround available', description: 'A task fails, but another way works.' },
        { label: 'Fully blocked', description: 'A task fails with no workaround.' },
      ],
    },
  ],
})
התשובה במדריך היא score: 1.1, עם הסתברות 0.1 לרמה 0, 0.7 לרמה 1 ו־0.2 לרמה 2, וביטחון של 0.55. הציון לא חייב להיות מספר שלם: 1.1 אומר ״יש דרך עוקפת, עם נטייה קלה לחסום״. הביטחון הנמוך יחסית הוא סימן לבדוק את המקרה ידנית.
איך קובעים ספים
המודל מחזיר מספרים, אבל ההחלטה מה עושים איתם היא שלכם. האם 0.92 מספיק כדי לשלוח תמונה לבדיקה ידנית? זה תלוי במחיר של כל טעות:
- התראת שווא (המודל אומר ״יש נזק״ וטעה) עולה זמן של בודק.
- פספוס (המודל אומר ״אין נזק״ וטעה) עולה לקוח שקיבל מוצר שבור.
ההמלצה של OpenAI: קחו דוגמאות אמיתיות מהמערכת שלכם עם תשובה ידועה, הריצו אותן, ובחרו סף לפי האיזון בין שני סוגי הטעויות. סף שנבחר בלי נתונים הוא ניחוש.
כמה שאלות בבקשה אחת
אפשר לשלוח כמה שאלות על אותו קלט באותה בקשה. למשל, לשאול על אותה תמונה גם ״האם יש נזק״ וגם ״לאיזו קטגוריה המוצר שייך״. זה חוסך זמן ועלות.
הכלל: שאלות בלתי תלויות באותה בקשה, שאלות תלויות בבקשות נפרדות. אם השאלה השנייה רלוונטית רק כשהתשובה לראשונה היא ״כן״, שלחו קודם את הראשונה, ורק אחר כך, לפי התשובה, את השנייה. אל תנסו לכתוב את התנאי בתוך ההוראות.
עוד כמה כללים לניסוח:
- נסחו לפי מה שאפשר לראות. ״יש סדק, קרע או שקע״ עדיף על ״המוצר פגום״.
- הפרידו היטב בין האפשרויות. שתי מחלקות עם תיאור דומה ייתנו הסתברויות קרובות וביטחון נמוך.
- ברמות של
score, ההבדל בין שתי רמות סמוכות צריך להיות ברור.
מחיר והגבלות
- מחיר: 0.10 דולר למיליון טוקנים של קלט. אין חיוב על טוקני פלט, וגם לא על קריאה מהמטמון או כתיבה אליו.
- מודל: רק
gpt-6-luna, בבטא ציבורית. - גרסאות SDK: JavaScript 7.30.0, Python 3.26.0, Go 3.73.0, Java 4.78.0, Ruby 0.101.0 ומעלה.
- פרטיות: תמיכה ב־Zero Data Retention וב־HIPAA ללקוחות מתאימים, ושמירת מידע בארה״ב או באירופה.
מתי לא להשתמש ב־Decisions
Decisions הוא כלי צר, וזה היתרון שלו. הוא לא מתאים כשצריך:
- יצירת טקסט: תשובה ללקוח, סיכום או הסבר. בשביל זה יש Responses API.
- חילוץ ערכים: שם, תאריך או סכום מתוך מסמך. בשביל זה יש Structured Outputs.
- קריאה לכלים: כשהמודל צריך להפעיל פונקציה עם פרמטרים, משתמשים ב־function calling.
החלוקה פשוטה: אם התשובה היא אחת מכמה אפשרויות ידועות מראש, או מספר, Decisions מתאים. אם התשובה היא טקסט, הוא לא.
בקצרה
- 01שואלים, לא מבקשים טקסט
predicate לשאלות של כן או לא, choice לניתוב, score לדירוג.
- 02בודקים refusal
לפני שקוראים את התשובה, מוודאים שהמודל לא סירב.
- 03קובעים ספים מנתונים
דוגמאות אמיתיות, ואיזון בין התראת שווא לפספוס.
- 04מאחדים רק שאלות בלתי תלויות
שאלה שתלויה בתשובה קודמת נשלחת בבקשה נפרדת.
הדוגמאות והנתונים לקוחים מהמדריך של Decisions API בתיעוד של OpenAI. ההסברים וההמלצות הם שלי.