Polars היא ספריית DataFrame (טבלאות נתונים בזיכרון, כמו pandas) שכתובה ב־Rust, עם API ל־Python. היא כבר נחשבת לאחת המהירות בתחום, וגרסה 2.0 ממשיכה בכיוון הזה: היא מטפלת בנתונים גדולים מהזיכרון, משפרת את SQL ומוסיפה טיפוס חדש. אבל זו גרסה ראשית, ויש בה שינויים שישנו לכם תוצאות בשקט, בלי שגיאה. ריכזתי כאן את החדש, ואת מה שצריך לבדוק בקוד לפני שמשדרגים.
הכתבה מבוססת על הכרזת Polars 2.0 מ־6 באוקטובר 2026 ועל מדריך השדרוג הרשמי.
מנוע streaming כברירת מחדל
זה השינוי הכי גדול. עד עכשיו, collect() על LazyFrame הריץ את השאילתה במנוע in-memory, שטוען הכול לזיכרון. ב־Polars 2.0 ברירת המחדל היא מנוע ה־streaming, שמעבד את הנתונים בחלקים.
lf = pl.LazyFrame({"a": ["x", "y", "z"], "b": [1, 2, 3]})
lf.group_by("a").agg(pl.all().sum()).collect()
# Polars 2.0: runs on the streaming engine
הקוד זהה, אבל המנוע שמריץ אותו התחלף. ברוב המקרים זה אומר שאילתות מהירות יותר וצריכת זיכרון נמוכה יותר. במקרה אחד זה אומר תוצאה אחרת, והוא בחלק הבא.
סדר השורות כבר לא מובטח
מנוע ה־streaming לא שומר על סדר השורות בפעולות כמו join, group_by ו־unpivot. אם הקוד שלכם מניח שהסדר נשמר, הוא ימשיך לרוץ בלי שגיאה, אבל עם תוצאה בסדר אחר.
הדוגמה הנפוצה היא join. עד עכשיו, left join שמר על סדר הטבלה השמאלית. עכשיו צריך לבקש את זה במפורש:
left = pl.LazyFrame({"k": [0, 1, 2], "l": ["a", "b", "c"]})
right = pl.LazyFrame({"k": [2, 1, 0], "r": ["x", "y", "z"]})

# Polars 2.0: the row order is not guaranteed
left.join(right, on="k", how="left").collect()

# Keep the order of the left table
left.join(right, on="k", how="left", maintain_order="left").collect()
ב־group_by ובפעולות אחרות יש maintain_order=True. אבל אם הסדר חשוב לכם, הפתרון הנקי הוא sort מפורש בסוף השאילתה: הוא מתעד את הכוונה ולא תלוי במנוע.
המקום הראשון שבו השינוי הזה יופיע הוא הבדיקות. בדיקה שמשווה תוצאה לטבלה צפויה שורה אחרי שורה עלולה להיכשל, גם כשהתוכן זהה. מיינו את שתי הטבלאות לפני ההשוואה, או השוו בלי תלות בסדר.
אם אתם צריכים זמן לעבור על הקוד, אפשר לחזור למנוע הישן:
pl.Config.set_engine_affinity("in-memory")  # for the whole process
lf.collect(engine="in-memory")  # for one query
או במשתנה סביבה, בלי לגעת בקוד:
POLARS_ENGINE_AFFINITY=in-memory python pipeline.py
זה פתרון זמני. כדאי להשתמש בו כדי לשדרג עכשיו ולתקן את הקוד בהדרגה, לא כדי להישאר עליו.
גלישה לדיסק כשהזיכרון נגמר
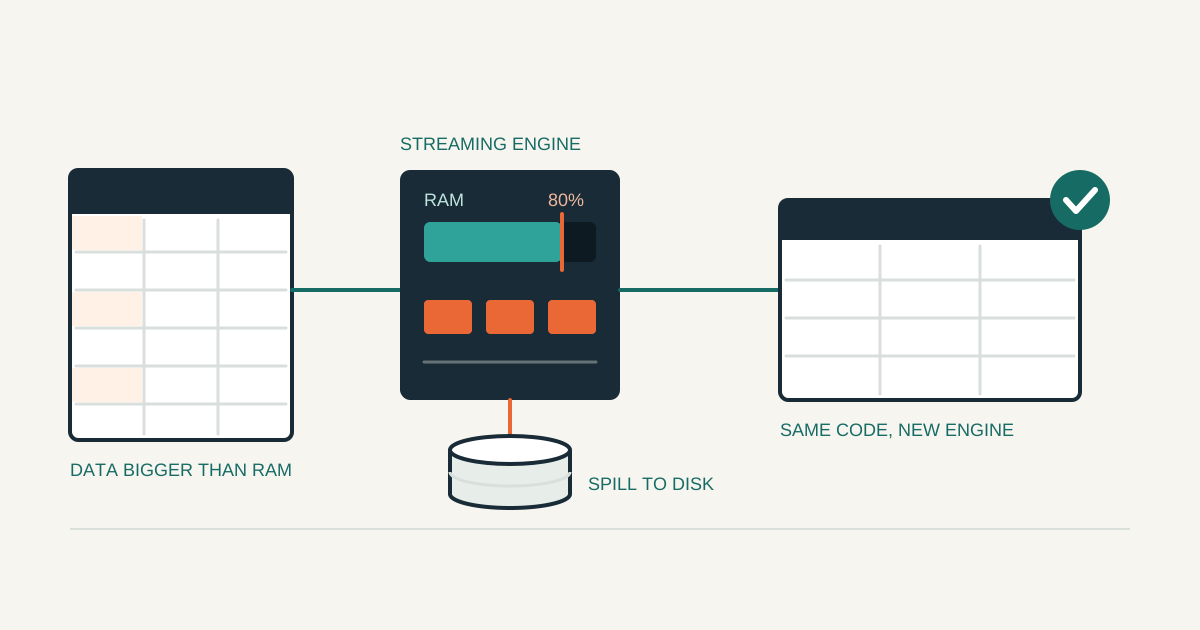
עד היום, נתונים גדולים מהזיכרון היו סוף הסיפור: התהליך קרס עם שגיאת זיכרון. ב־Polars 2.0 תמיכת out-of-core (עבודה עם נתונים גדולים מהזיכרון, דרך כתיבה זמנית לדיסק) פעילה כברירת מחדל:
- מתי זה מתחיל: כשהשימוש בזיכרון מגיע לכ־80% מה־RAM. לפי צוות Polars, ייתכן שתצטרכו לכוונן את זה.
- כמה דיסק: תקציב ברירת מחדל של 64GB.
- אילו פעולות: מיון, פונקציות חלון (window functions) והרבה ביטויים. join ו־group_by עוד לא, והם הבאים בתור.
המשמעות המעשית: שאילתה שקרסה על מכונה קטנה עשויה עכשיו להצליח, רק לאט יותר. אם אתם מריצים על שרת עם דיסק קטן או בקונטיינר, שימו לב שיש מקום לכתיבה הזמנית.
טיפוס חדש: Map
Polars 2.0 מוסיף את pl.Map, טיפוס של מפתח וערך שתואם ל־MapType של Arrow. עד עכשיו, מבנה כזה נשמר כרשימה של struct, והשליפה ממנו הייתה מסורבלת.
df = pl.DataFrame(
    {
        "user": ["alice", "bob", "carol"],
        "scores": pl.Series(
            [{"math": 90, "art": 75}, {"math": 60}, {}],
            dtype=pl.Map(pl.String, pl.Int64),
        ),
        "subject": ["art", "art", "math"],
    }
)

df.select(
    "user",
    pl.col("scores").map.get("math").alias("math"),
    pl.col("scores").map.get(pl.col("subject")).alias("by_subject"),
    pl.col("scores").map.contains_key("art").alias("has_art"),
    pl.col("scores").map.len().alias("n"),
    pl.col("scores").map.keys().alias("keys"),
    pl.col("scores").map.values().alias("values"),
)
שימו לב ל־map.get(pl.col("subject")): המפתח יכול להגיע מעמודה אחרת, כך שכל שורה שולפת מפתח אחר.
השינוי הזה גם שובר קוד קיים: עמודות map שנקראות מ־Arrow או מ־Parquet נטענות עכשיו כ־pl.Map ולא כ־List(Struct). אם קוד שלכם עבד עם המבנה הישן, map.entries() מחזיר אותו:
pl.from_arrow(tbl).select(pl.col("m").map.entries())
טיפוסים קשוחים יותר
העיקרון של Polars 2.0: התנהגות מרומזת כשהטיפוסים לא מתאימים צריכה להיות בחירה מפורשת, לא ברירת מחדל, כי היא מסתירה באגים. הנה השינויים שסביר שתיתקלו בהם:
| מה | לפני | ב־Polars 2.0 |
|---|---|---|
is_in בין int ל־float | השוואה עם אובדן דיוק | InvalidOperationError, צריך cast מפורש |
cast(pl.Date) על מחרוזת | עבד | הוסר, משתמשים ב־str.to_date() |
concat אופקי בגבהים שונים | מילא ב־null בשקט | ShapeError, או how="horizontal_extend" |
schema_overrides ב־CSV כרשימה | אפשר לכסות חלק מהעמודות | חייב לכסות את כל העמודות |
לדוגמה, המרת מחרוזת לתאריך:
# Before
pl.Series(["2022-08-30"]).cast(pl.Date)

# Polars 2.0
pl.Series(["2022-08-30"]).str.to_date()
החדשות הטובות: רוב השינויים האלה זורקים שגיאה. קוד שנשבר יגיד לכם איפה, ולא ייתן תוצאה שגויה בשקט.
שינויים שקטים ששווה לבדוק
בניגוד לחלק הקודם, השינויים האלה לא זורקים שגיאה. הם משנים את התוצאה:
explodeעל רשימה ריקה לא מחזיר יותר שורת null, אלא אפס שורות. טבלה של שלוש רשימות, אחת מהן ריקה, תיתן פחות שורות מבעבר.empty_as_null=Trueמחזיר את ההתנהגות הישנה.- שמות עמודות ב־CSV בלי כותרת מתחילים עכשיו מ־
column_0ולא מ־column_1. קוד שבוחר עמודה לפי שם כזה יקבל עמודה אחרת. - קריאה מ־
BytesIOלא חוזרת לתחילת הקובץ לבד. אחריwrite_parquet(buf)צריךbuf.seek(0)לפניread_parquet(buf). df.drop("*")שומר על מספר השורות: טבלה של שלוש שורות תהיה בצורה(3, 0)ולא(0, 0).
ושני שמות שהוסרו אחרי תקופת deprecation ארוכה: melt() הוחלף ב־unpivot(), ו־with_row_count() הוחלף ב־with_row_index(), שיוצר עמודה בשם index ולא row_nr.
SQL, אופטימיזציה ומהירות
Polars משקיעה ב־SQL כממשק מלא, לא כתוספת. הכיסוי של SQL גדל משמעותית בחודשים האחרונים, ויש שלושה שיפורים באופטימייזר:
- סידור מחדש של joins: Polars בוחרת את סדר ה־joins בעצמה, במקום לבצע אותם לפי הסדר שכתבתם.
- חיסול תת־תוכניות משותפות (common subplan elimination): חלק שמופיע כמה פעמים בשאילתה מחושב פעם אחת.
- פרדיקטים דינמיים ו־bloom filters: סינון שנבנה בזמן הריצה, ומדלג על נתונים שבוודאות לא יתאימו ל־join.
לפי צוות Polars, גרסה 2.0 מובילה מול ספריות DataFrame אחרות ומול DuckDB במבחני TPC-H ו־TPC-DS. ההשוואה נעשתה מול DuckDB 1.5.6, DuckDB 2.0 alpha ו־DataFusion 54.0.0, על מכונה עם 16 ליבות ועל מכונה עם 192 ליבות. הצוות מציין בעצמו נקודת חולשה: ב־192 ליבות יש תקורה קבועה שפוגעת בשאילתות על נתונים קטנים.
איך משדרגים בלי הפתעות
1. עדכנו את Polars בסביבת פיתוח, לא ישר בפרודקשן.
2. הריצו את הבדיקות. כשל בהשוואת טבלאות הוא כנראה סדר שורות.
3. חפשו בקוד join, group_by ו־unpivot שהתוצאה שלהם תלויה בסדר, והוסיפו sort או maintain_order.
4. חפשו explode, קריאת CSV בלי כותרת ו־BytesIO: אלה השינויים שלא זורקים שגיאה.
5. תקנו את השגיאות שנזרקות: cast, is_in, concat ושמות שהוסרו.
6. אם צריך עוד זמן, הגדירו POLARS_ENGINE_AFFINITY=in-memory ותקנו בהדרגה.
בקצרה
- 01streaming כברירת מחדל
collect רץ על מנוע ה־streaming, וסדר השורות כבר לא מובטח.
- 02גלישה לדיסק
מ־80% RAM, עם תקציב של 64GB, למיון ולפונקציות חלון.
- 03טיפוס Map
מפתח וערך כמו ב־Arrow, עם get, keys ו־contains_key.
- 04טיפוסים קשוחים
פחות התנהגות מרומזת: שגיאה במקום תוצאה שגויה.
הכתבה מבוססת על הכרזת Polars 2.0 ועל מדריך השדרוג ל־Polars 2. שם תמצאו את הרשימה המלאה של השינויים. הסידור והמסקנות הם שלי.